Meta ha actualizado sus condiciones comerciales y, según un reportaje de Nieman Lab recogido por The Verge, el nuevo texto podría permitirle rastrear las webs de empresas y medios de comunicación para entrenar su inteligencia artificial sin necesidad de un acuerdo de licencia previo. Las condiciones entran en vigor el 30 de octubre.
El asunto cobra relevancia porque afecta a cualquier página de empresa en Facebook, Instagram, WhatsApp o Messenger, incluidos los medios que usan estas plataformas para promocionar sus contenidos. La compañía niega que haya cambios de fondo, pero juristas consultados advierten de un margen de interpretación mucho más amplio.
Qué dice la cláusula de Meta
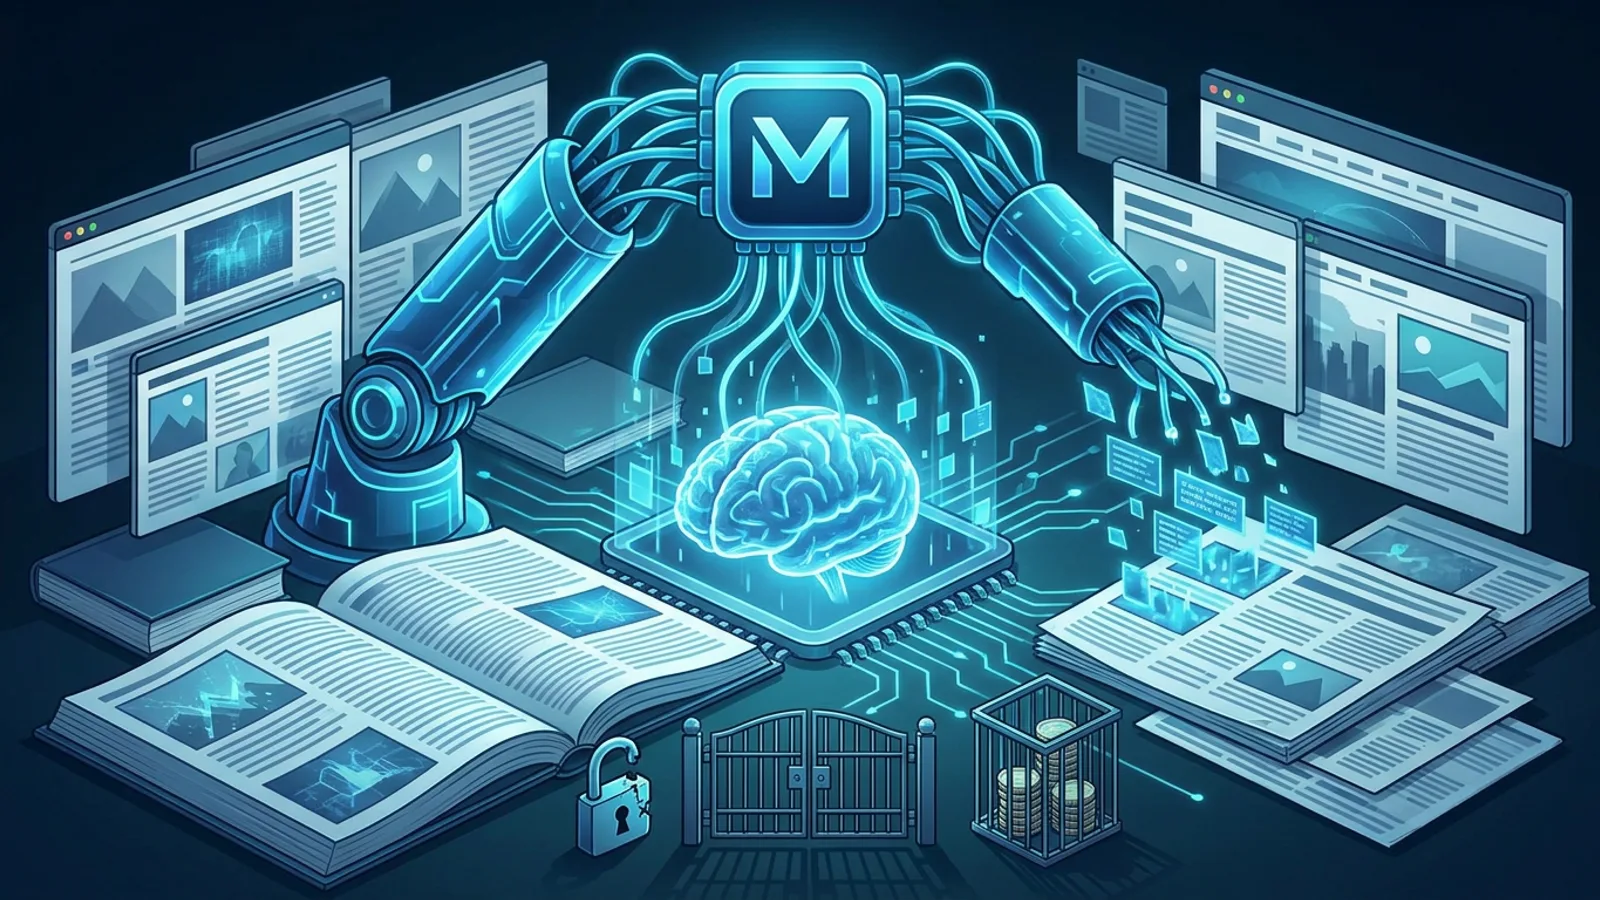
El nuevo texto autoriza a Meta, o a cualquier entidad que actúe en su nombre, a usar herramientas automatizadas como rastreadores, bots o arañas web para acceder, indexar, almacenar en caché, analizar y recopilar los dominios, páginas o URL «asociados» a los productos o servicios de cada cliente.
Esa autorización se extiende también a direcciones accesibles a través del uso que hagan de los productos de Meta tanto el cliente como sus usuarios. La empresa se reserva además la posibilidad de crear credenciales de prueba y extraer actualizaciones de forma periódica.
El uso del contenido no se limita a fines publicitarios. Según el texto, Meta puede emplearlo para «proporcionar, desarrollar, mejorar, investigar, entrenar y mantener la integridad» de sus productos y servicios.
A quién afecta: Facebook, Instagram, WhatsApp y Messenger
La política alcanza a las cuentas de empresa que promocionan contenido en Facebook, Instagram, WhatsApp y Messenger. Cualquier medio que invierta en anuncios para captar lectores o que gestione una página comercial queda dentro del perímetro de estas condiciones.
El texto incluye además una advertencia directa: quienes no acepten la política pueden perder el acceso a los productos de Meta con fines empresariales o comerciales. En la práctica, rechazar las condiciones implica renunciar a la herramienta publicitaria.
La versión de Meta frente a la lectura de los juristas
Daniel Roberts, portavoz de Meta, sostiene que la compañía únicamente está consolidando sus condiciones comerciales y de autoservicio de anuncios. Según su respuesta, no hay ningún cambio en cómo Meta usa los rastreadores web y cualquier sugerencia en sentido contrario sería falsa. Roberts añade que los propietarios de contenido pueden seguir usando el archivo robots.txt para marcar sus preferencias.
Andy Stone, vicepresidente de comunicaciones de Meta, publicó en X que la actualización busca obtener información precisa sobre productos a la venta en webs de terceros, con el fin de mejorar la recomendación de anuncios y contenidos en la plataforma. Stone precisó que el objetivo no es rastrear sitios de noticias.
Los juristas citados por Nieman Lab plantean una lectura distinta. Según el medio, las condiciones podrían dar pie a que Meta argumente que sus cláusulas comerciales prevalecen sobre otras instrucciones de bloqueo, como el propio archivo robots.txt de cada sitio.
El papel del archivo robots.txt
El robots.txt es el mecanismo con el que una web indica a los rastreadores qué contenido puede leerse. Ha sido hasta ahora la principal defensa de los editores frente al uso de sus textos para entrenar modelos de IA. Si un contrato comercial con Meta pudiera pesar más que ese archivo, esa barrera perdería buena parte de su efecto práctico.
James Grimmelmann, profesor de derecho digital y de la información en Cornell, lo resume ante Nieman Lab señalando que, para los editores de noticias, el texto representa un permiso para que Meta entrene su IA con cualquier contenido de sus sitios y, posiblemente, despliegue parte de ese contenido incluso en competencia con los propios medios.
Un ejemplo del riesgo para los editores
El problema se entiende mejor con un caso práctico. Un diario regional contrata anuncios en Instagram para promocionar un reportaje de pago. Con la nueva cláusula, Meta podría rastrear todo el dominio del diario, no solo esa pieza concreta, y usarlo para entrenar sus modelos, aunque ese medio hubiera bloqueado expresamente a otros rastreadores mediante robots.txt.
El contraste con los acuerdos de licencia ya firmados
Meta ya ha seguido el camino de OpenAI al cerrar acuerdos de licencia de contenidos para IA con CNN, Fox News, USA Today y People Inc. En esos casos, la compañía paga por acceder a material concreto y negociado previamente con cada medio.
Las nuevas condiciones comerciales podrían darle acceso a un volumen de contenido mucho mayor sin pasar por ese tipo de negociación, lo que preocupa especialmente a los editores que no cuentan con un acuerdo propio con Meta.
Meta One y el cobro por enlazar contenido
El mes pasado, Meta lanzó la suscripción Meta One, que obliga a empresas y creadores a pagar para incluir enlaces en publicaciones y reels. Nieman Lab subraya que Meta ha empezado a cobrar a los usuarios por publicar enlaces al mismo contenido que, según las nuevas condiciones, podría rastrear de forma gratuita.
La combinación tiene un efecto económico directo: un editor paga por enlazar su propio contenido, acepta unas condiciones que permiten rastrearlo para entrenar IA y, si las rechaza, pierde el acceso comercial a la plataforma.
Qué revisar antes del 30 de octubre
Quienes gestionan una web con presencia comercial en Meta pueden comprobar varios puntos derivados de las nuevas condiciones:
Leer el texto completo de las condiciones comerciales, prestando atención a la cláusula sobre dominios «asociados» a productos o servicios.
Revisar el archivo robots.txt propio. Meta asegura que sigue respetándolo, pero los juristas consultados advierten de que la empresa podría alegar que sus condiciones comerciales prevalecen sobre él.
Consultar con un asesor jurídico si existe un acuerdo de licencia con otra empresa de IA que pueda entrar en conflicto con las nuevas condiciones de Meta.
Valorar qué dominios están vinculados a las cuentas de empresa, ya que la cláusula se aplica a aquellos asociados a los productos o servicios promocionados.
Qué significa esto en la práctica
Si un medio o un negocio anuncia en Facebook, Instagram, WhatsApp o Messenger, aceptar las condiciones que entran en vigor el 30 de octubre puede implicar ceder a Meta la lectura de su web para entrenar inteligencia artificial. Rechazarlas, en cambio, puede suponer perder el acceso a las herramientas comerciales de la plataforma.
Meta insiste en que no hay cambios reales y que el objetivo es mejorar la recomendación de anuncios. Los expertos jurídicos citados por Nieman Lab consideran que el texto es lo bastante amplio como para ir más allá de esa explicación. Mientras no haya una aclaración por escrito que limite ese alcance, prevalece lo que dice el contrato firmado.
Preguntas frecuentes
¿Cuándo entran en vigor las nuevas condiciones de Meta?
Las nuevas condiciones comerciales de Meta entran en vigor el 30 de octubre.
¿A quién afectan exactamente estas condiciones?
Afectan a las cuentas de empresa que promocionan contenido en Facebook, Instagram, WhatsApp y Messenger, incluidos medios de comunicación que usan estas plataformas para publicitar sus contenidos.
¿Meta reconoce que va a rastrear las webs de los medios para entrenar su IA?
No. Meta, a través de su portavoz Daniel Roberts, sostiene que no hay ningún cambio en cómo usa sus rastreadores web y que solo está consolidando condiciones comerciales ya existentes.
¿El archivo robots.txt sigue protegiendo el contenido de una web frente a Meta?
Meta afirma que respeta las marcas de robots.txt, pero juristas citados por Nieman Lab advierten de que la compañía podría argumentar que sus condiciones comerciales prevalecen sobre ese archivo.
¿Qué pasa si una empresa rechaza las nuevas condiciones?
Según el propio texto de Meta, quienes no acepten la política pueden perder el acceso a los productos de la compañía con fines empresariales o comerciales.
¿Meta ya paga a algunos medios por usar su contenido en IA?
Sí. Meta tiene acuerdos de licencia de contenidos para IA con CNN, Fox News, USA Today y People Inc, en los que paga por material concreto negociado previamente.
¿Qué relación tiene esto con Meta One?
Meta One es una suscripción lanzada el mes pasado que obliga a empresas y creadores a pagar para incluir enlaces en publicaciones y reels, mientras las nuevas condiciones podrían permitirle rastrear ese mismo contenido sin coste adicional.
Samuel Gil es especialista en infraestructura tecnológica, administración de servidores y desarrollo de servicios digitales. Con una sólida trayectoria en entornos web de alta exigencia, optimización de servidores y gestión de arquitecturas de red, Samuel dedica su labor en faq-box.com a desglosar cuestiones técnicas complejas para convertirlas en guías prácticas, transparentes y de alto valor técnico.
Su enfoque editorial prioriza el rigor, la seguridad en los sistemas y la resolución eficiente de problemas técnicos cotidianos y avanzados. A través de sus análisis, busca ofrecer respuestas directas y contrastadas para profesionales y entusiastas del sector tecnológico.
Cuenta con una sólida formación en el área tecnológica, destacando su especialización a través del Máster en Inteligencia Artificial Aplicada a la Gestión Empresarial y el MBA in Digital Transformation & Artificial Intelligence de ISEEN.EU, lo que aporta un rigor técnico avanzado a cada análisis de desarrollo y arquitectura digital.