Un equipo de científicos del Instituto Weizmann de Ciencias, en Rejovot (Israel), ha desarrollado un sistema de inteligencia artificial capaz de reconstruir imágenes a partir de resonancias cerebrales con un nivel de detalle que supera a las herramientas anteriores. El avance, presentado el mes pasado en la conferencia Cognitive Computational Neuroscience en Nueva York, reabre el debate sobre hasta dónde puede llegar la tecnología que interpreta la actividad del cerebro humano.
La investigación está liderada por Michal Irani, científica de la computación, y plantea aplicaciones que van desde la comunicación con pacientes paralizados hasta la comprensión de fenómenos como los flashbacks del estrés postraumático. Pero también abre interrogantes sobre la privacidad mental en un momento en que los sistemas de IA avanzan más rápido que la regulación que los acompaña.
Dos ramas para una imagen más fiel
Los sistemas previos de reconstrucción mediante resonancia magnética funcional (fMRI) generaban imágenes borrosas o imprecisas. Según Irani, aunque la calidad de los escáneres y las herramientas de análisis han mejorado con los años, los modelos existentes seguían sin alcanzar el nivel necesario para resultar útiles.
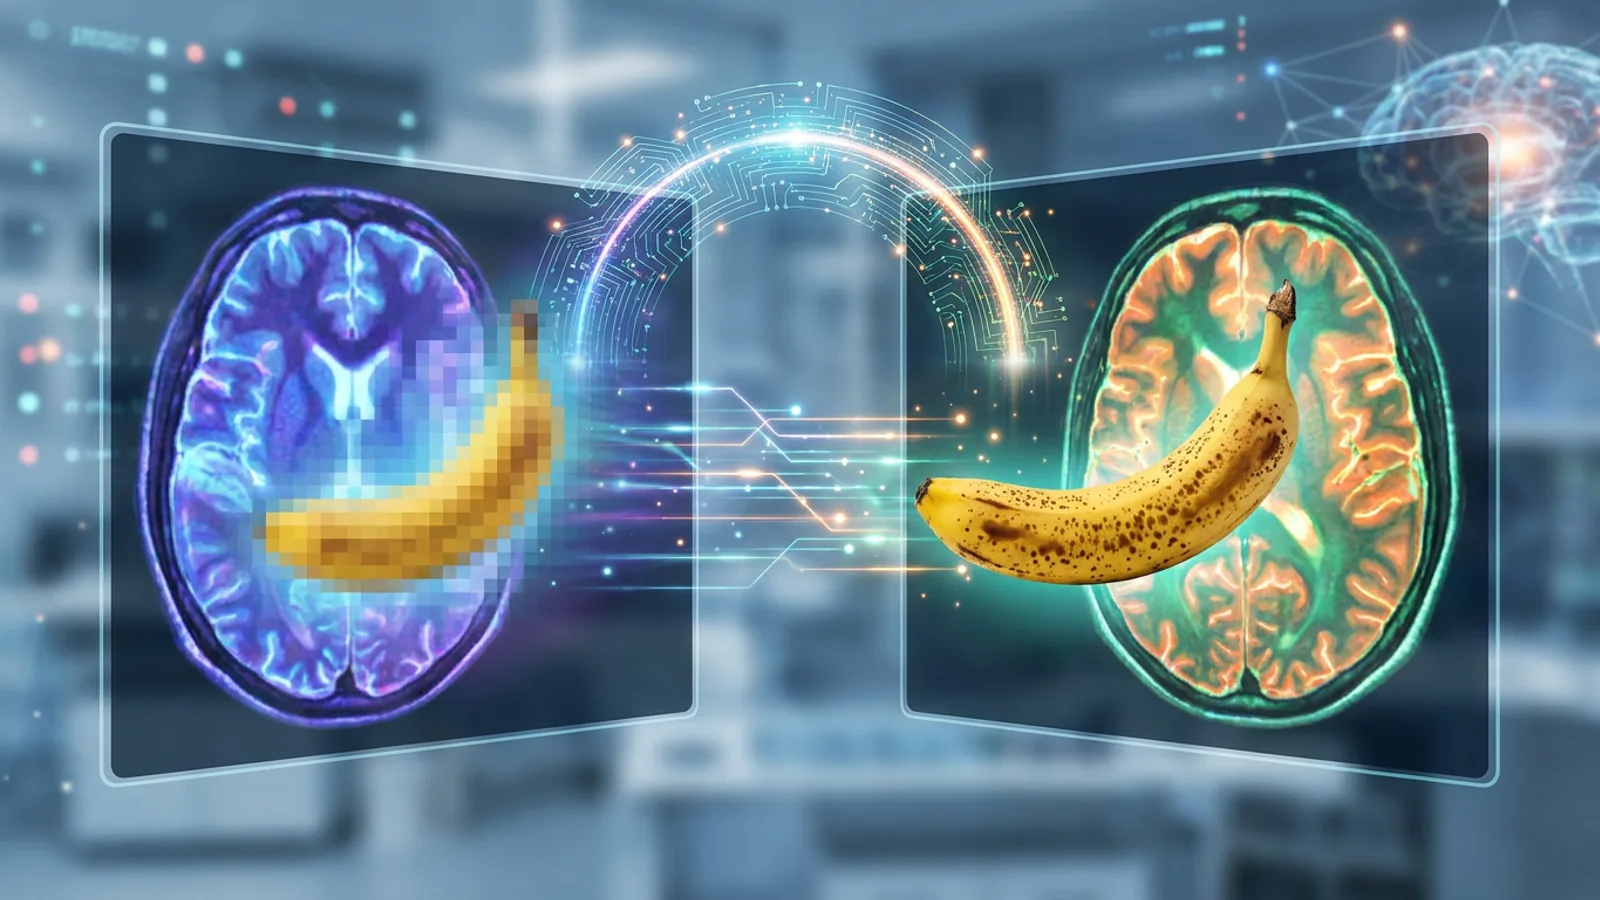
La investigadora pone como ejemplo un plátano: los modelos anteriores podían generar la imagen de un plátano, pero no necesariamente con la misma forma, color o posición que el original visto por la persona escaneada.
Para resolverlo, el equipo entrenó lo que llaman un decodificador cerebral, utilizando datos públicos de ocho personas a las que se mostraron alrededor de 9.000 imágenes dentro de un escáner de alta resolución. Este decodificador funciona con dos ramas simultáneas: una predice la estructura visual de la imagen, como la disposición de los colores, y otra predice el contenido, por ejemplo un racimo de plátanos sobre un plato. Ambas predicciones alimentan después a un modelo de difusión, el tipo de IA que genera imágenes limpiando gradualmente el ruido visual hasta obtener un resultado nítido.
El truco para entrenar con más datos de los disponibles
El principal obstáculo de este tipo de investigación es el coste. Escanear a una persona con fMRI es caro y el tiempo de máquina limita cuántas imágenes se le pueden mostrar durante un experimento.
El equipo de Irani resolvió esta limitación entrenando un segundo modelo, un codificador que realiza el proceso inverso al decodificador: predice cómo sería la actividad cerebral de alguien que observa una imagen concreta. El sistema funciona así: se toma una fotografía nueva, por ejemplo un leopardo, y el codificador predice qué actividad cerebral generaría esa imagen. Después, el decodificador intenta reconstruir la fotografía original a partir de esa actividad simulada.
Al principio, según reconoce Irani, el resultado apenas se parece a un leopardo. Pero repetir este ciclo de retroalimentación mejora notablemente ambas herramientas. Esto permite entrenar el sistema con muchas más imágenes de las que realmente se mostraron en un escáner real. De hecho, Irani estima que alrededor del 70 % de los datos de entrenamiento proviene de imágenes que nunca estuvieron emparejadas originalmente con una resonancia.
De 40 horas de escáner a solo una
Al combinar datos de distintos estudios, los investigadores detectaron regiones cerebrales que parecen cumplir funciones similares en todas las personas: una zona responde a imágenes de comida y otra a imágenes relacionadas con el deporte, por ejemplo. Esto permitió construir lo que el equipo denomina un codificador cerebral universal, capaz de adaptarse al escáner de una persona nueva con una calibración mínima.
Aquí está la diferencia práctica más relevante del trabajo. Según Irani, otras herramientas suelen necesitar unas 40 horas de datos de fMRI de cada persona nueva antes de poder predecir lo que está viendo. El sistema de su equipo solo requiere una hora de escáner.
Tommy Sprague, neurocientífico de la Universidad de California en Santa Bárbara que no participó en el estudio, subraya el impacto de esta reducción para los laboratorios: ningún equipo de investigación puede permitirse 40 horas de imágenes por cada sujeto nuevo. Según sus cálculos, una hora de escáner cuesta entre 600 y 1.000 dólares.
Los límites del sistema
La herramienta todavía comete errores evidentes. Irani ha mostrado ejemplos en los que el sistema reconstruyó una tarta como una pila de tres sándwiches, o convirtió un perro dentro de una bañera en una cabra del mismo color dentro de la misma bañera.
Aun con esos fallos, en pruebas comparativas el sistema superó con claridad a las herramientas descritas hasta ahora en la literatura científica. Irani prefiere no utilizar la expresión lectura de mente, que considera más un reclamo llamativo que una descripción precisa de lo que hace realmente el sistema.
El objetivo: vídeo, audio y hasta los sueños
El siguiente paso del laboratorio es pasar de reconstruir imágenes fijas a reconstruir vídeo y audio. Irani aspira a que la tecnología llegue a reproducir lo que una persona piensa, imagina o incluso sueña, aunque admite que ese objetivo todavía no se ha alcanzado.
Entre las aplicaciones más prometedoras figura la posibilidad de que personas con síndrome de enclaustramiento, completamente paralizadas pero conscientes, puedan comunicarse únicamente a través de su actividad cerebral. La tecnología también podría ayudar a entender mejor fenómenos como los flashbacks asociados al trastorno de estrés postraumático.
Judy Illes, neuroeticista y profesora de neurología en la Universidad de la Columbia Británica, en Canadá, que no participó en la investigación, ha calificado el trabajo como extraordinario y ha destacado el potencial terapéutico de aplicar este enfoque a personas con afecciones neurológicas.
El debate pendiente sobre la privacidad mental
Avances como este reavivan una pregunta incómoda: qué ocurriría si alguien pudiera reconstruir pensamientos o recuerdos ajenos sin consentimiento. Sprague reconoce que hace una década habría descartado esa posibilidad sin más, dado lo difícil que resulta conseguir que una persona colabore activamente dentro de un escáner durante un experimento.
Sin embargo, el propio equipo de Irani y otros grupos de investigación ya trabajan con electroencefalografía (EEG), una tecnología que mide la actividad eléctrica cerebral mediante gorros de electrodos o incluso auriculares, y que resulta mucho más accesible que la resonancia magnética. A medida que los modelos de IA mejoren, analizar ese tipo de datos será cada vez más sencillo.
Sprague advierte que si llega a existir una forma de extraer de manera encubierta información sobre lo que una persona está pensando, escenarios que durante 150 años pertenecieron a la ciencia ficción podrían materializarse en cualquier momento. Por eso pide que las consideraciones éticas sobre este tipo de tecnología se tomen más en serio.
Qué significa este avance a corto plazo
El impacto más inmediato se producirá en los propios laboratorios de neurociencia. Reducir de 40 a una hora el tiempo de escáner necesario por voluntario abarata considerablemente el coste de este tipo de estudios, lo que podría abrir la puerta a investigaciones con presupuestos más ajustados.
Para pacientes con parálisis severa, la promesa a largo plazo es una forma de comunicación asistida, aunque Irani misma reconoce que ese objetivo todavía no está resuelto. Y para el público en general, el avance obliga a seguir de cerca el debate sobre la regulación de los datos cerebrales, una discusión que hoy depende de la cooperación voluntaria dentro de un escáner, pero que podría cambiar si la tecnología EEG, más accesible, continúa perfeccionándose.
Preguntas frecuentes
¿Qué hace exactamente esta inteligencia artificial?
Reconstruye imágenes que una persona ha visto a partir de su actividad cerebral registrada mediante resonancia magnética funcional, y también puede predecir qué actividad cerebral generaría una imagen determinada.
¿Quién lidera esta investigación?
El proyecto está dirigido por Michal Irani, científica de la computación del Instituto Weizmann de Ciencias, en Rejovot, Israel.
¿Cuánto tiempo de escáner necesita una persona nueva para usar el sistema?
Según Irani, su decodificador solo requiere una hora de datos de fMRI de una persona nueva, frente a las 40 horas que suelen necesitar otras herramientas similares.
¿La tecnología puede leer sueños o pensamientos?
Todavía no. El equipo trabaja para extender el sistema a vídeo, audio y eventualmente a pensamientos o sueños, pero esa capacidad aún no existe.
¿Qué errores comete el sistema actualmente?
Entre los fallos documentados, el sistema ha confundido una tarta con una pila de sándwiches y un perro en una bañera con una cabra del mismo color en el mismo entorno.
¿Qué riesgos de privacidad plantea esta tecnología?
Expertos como Tommy Sprague advierten que, si en el futuro fuera posible extraer información mental de forma encubierta, surgirían preocupaciones éticas serias, especialmente a medida que se combine con tecnologías más accesibles como el EEG.
¿Esta tecnología ya puede ayudar a pacientes paralizados?
Es una de las aplicaciones que persigue el laboratorio, pensada para personas con síndrome de enclaustramiento, pero Irani reconoce que esa solución todavía no está desarrollada.
Samuel Gil es especialista en infraestructura tecnológica, administración de servidores y desarrollo de servicios digitales. Con una sólida trayectoria en entornos web de alta exigencia, optimización de servidores y gestión de arquitecturas de red, Samuel dedica su labor en faq-box.com a desglosar cuestiones técnicas complejas para convertirlas en guías prácticas, transparentes y de alto valor técnico.
Su enfoque editorial prioriza el rigor, la seguridad en los sistemas y la resolución eficiente de problemas técnicos cotidianos y avanzados. A través de sus análisis, busca ofrecer respuestas directas y contrastadas para profesionales y entusiastas del sector tecnológico.
Cuenta con una sólida formación en el área tecnológica, destacando su especialización a través del Máster en Inteligencia Artificial Aplicada a la Gestión Empresarial y el MBA in Digital Transformation & Artificial Intelligence de ISEEN.EU, lo que aporta un rigor técnico avanzado a cada análisis de desarrollo y arquitectura digital.